Blockchain, denumit inițial lanț de blocuri, este o listă în continuă creștere de înregistrări numite blocuri, care comunică între ele prin mesaje criptografiate. Fiecare bloc conține un hash criptografic al blocului anterior, un marcaj de timp și datele tranzacției. Prin proiectare, un blockchain este „un registru deschis, distribuit, care poate înregistra tranzacțiile între două părți eficient și într-un mod verificabil și permanent”, de obicei gestionat de o rețea peer-to-peer care aderă la un protocol pentru comunicarea între noduri și validarea de noi blocuri. După înregistrare, datele dintr-un bloc dat nu pot fi modificate retroactiv fără modificarea tuturor blocurilor ulterioare, ceea ce necesită consensul rețelei.
Acesta este un articol cu Acces Deschis distribuit în conformitate cu termenii licenței de atribuire Creative Commons CC BY 4.0 (http://creativecommons.org/licenses/by/4.0/), care permite utilizarea, distribuirea și reproducerea fără restricții pe orice mediu, cu condiția ca lucrarea originală să fie citată corect.
This is an Open Access article distributed under the terms of the Creative Commons Attribution License CC BY 4.0 (http://creativecommons.org/licenses/by/4.0/), which permits unrestricted use, distribution, and reproduction in any medium, provided the original work is properly cited.
Tehnologia blockchain
Nicolae Sfetcu
Internetul a schimbat complet lumea, cultura și obiceiurile oamenilor. După o primă fază caracterizată prin transferul liber al informațiilor, au apărut preocupările pentru siguranța comunicațiilor online și confidențialitatea utilizatorilor. Tehnologia blockchain (TB) asigură ambele aceste deziderate. TB, relativ nouă, are șansa să producă o nouă revoluție, justificând din plin o anchetă filosofică.
Primul blockchain a fost conceptualizat de Satoshi Nakamoto, în 2008, folosind o metodă care exclude o terță parte autorizată. (Narayanan et al. 2016) În 2009 Nakamoto dezvoltat bitcoin pe baza TB, folosită ca registru public pentru tranzacțiile din rețea. (The Economist 2015)
(Formarea canalului de blocuri sub forma arborelui Merkle. Lanțul principal (B0…B8) constă din cea mai lungă serie de blocuri pornind de la blocul inițial (B0) până la blocul curent (B8). Toate celelalte blocuri sunt blocuri orfane care se găsesc în afara lanțului principal.)
Începând din 2014 s-au dezvoltat noi aplicații ale tehnologiei, (Nian and Chuen 2015) cunoscute generic ca blockchain 2.0, pentru contracte inteligente mai sofisticate, care partajează documente sau trimit automat dividendele proprietarilor dacă profiturile ajung la un anumit nivel. În Ingineria filosofică: spre o filosofie a webului, Halpin și Monnin au pus în discuție anumite aspecte filosofice ale acestei tehnologii emergente, (Halpin and Monnin 2014) precum relația dintre lumea fizică și lumea virtuală, individul și societatea, conceptele de materialitate, întrupare, temporalitate, spațialitate și posibilitate. (Institute for Blockchain Studies 2016) Ontologic ne putem întreba ce este această tehnologie, cum ar putea fi caracterizată, cum se creează, se implementează și se adoptă, și cum funcționează; definiții, clasificări, posibilități și limitări. Din punct de vedere epistemologic ne preocupă ce cunoaștere se poate obține prin TB, cum se situează ea în raport cu realitatea, ce cunoștințe implică utilizarea tehnologiei, etc. De asemenea ne interesează modul în care TB poate fi valorificată, ce aspecte permit o evaluare, ce norme comportamentale implică, aspecte estetice și morala implicată de folosirea acestei tehnologii. Filosofia TB poate fi văzută ca o resursă conceptuală pentru înțelegerea acestor evoluții în lumea noastră modernă. (Swan and Filippi 2017) Metaforele conceptuale ne pot ajuta să abordăm și să înțelegem noile idei. (Lakoff and Johnson 2003)
Blockchain, (The Economist 2015) (Morris 2016) (Popper 2017) denumit inițial lanț de blocuri, (Brito and Castillo 2016) (Trottier [2013] 2018) este o listă în continuă creștere de înregistrări numite blocuri, care comunică între ele prin mesaje criptografiate. (The Economist 2015) Fiecare bloc conține un hash criptografic al blocului anterior, (Narayanan et al. 2016) un marcaj de timp și datele tranzacției.
Prin proiectare, un blockchain este „un registru deschis, distribuit, care poate înregistra tranzacțiile între două părți eficient și într-un mod verificabil și permanent”, (Iansiti and Lakhani 2017) de obicei gestionat de o rețea peer-to-peer care aderă la un protocol pentru comunicarea între noduri și validarea de noi blocuri. După înregistrare, datele dintr-un bloc dat nu pot fi modificate retroactiv fără modificarea tuturor blocurilor ulterioare, ceea ce necesită consensul rețelei. Blockchain poate fi considerat un sistem sigur prin proiectare, distribuit, cu o toleranță ridicată la erori. (Raval 2016) Criptografia blocurilor folosește chei publice. (Brito and Castillo 2016, 5) Cheile private permit accesul proprietarilor la activele lor digitale sau posibilitatea de a interacționa în cadrul blockchain. (The Economist 2015)
Fiecare nod dintr-un sistem are o copie a blockchain. (Raval 2016) Nu există o copie „oficială” centralizată, și nici un utilizator „de încredere” mai mult decât oricare altul. (Brito and Castillo 2016) Nodurile miniere validează tranzacțiile, (Tapscott and Tapscott 2016) le adaugă la blocul pe care îl construiesc și apoi difuzează blocul completat la alte noduri. (Bhaskar and Chuen 2015, chap. 3) Blockchain utilizează diverse scheme de marcaje temporale, cum ar fi proof-of-work, pentru a serializa schimbările. (Gervais, Karame, and Capkun 2015)
Alte aplicații blockchain în curs de dezvoltare țin de guvernarea electronică, precum Bitnation, (Allison 2015) inițiative pentru implicarea cetățenilor și noi forme de participare democratică precum D-Cent (D-Cent 2015) și platforme digitale pentru crearea de diverse aplicații descentralizate, cum ar fi platforma Ethereum. (Wood 2014) Tehnologia blockchain este considerată a avea o contribuție deosebit de importantă în viitoarea transformare a organizațiilor, guvernarea democratică și cultura umană în ansamblu. (Tapscott, Tapscott, and Cummings 2017)
Potrivit unor statistici sintetizate de Forumul Economic Mondial, interesul pentru blockchain s-a extins la nivel global, (WEF Financial Services 2016) aproape 30 de țări investesc în prezent în proiecte de tip blockchain.
Există trei tipuri de rețele blockchain – publice (nicio restricție de acces), private (accesul pe bază de invitație de administratorii de rețea, iar participanții și validatorii sunt restricționați), și de consorțiu (semi-descentralizat, cu acces limitat de administratorii lanțului).
Bibliografie
Allison, Ian. 2015. “Decentralised Government Project Bitnation Offers Refugees Blockchain IDs and Bitcoin Debit Cards.” International Business Times UK. 2015. https://www.ibtimes.co.uk/decentralised-government-project-bitnation-offers-refugees-blockchain-ids-bitcoin-debit-cards-1526547.
Bhaskar, Nirupama Devi, and David LEE Kuo Chuen. 2015. “Bitcoin Mining Technology.” In Handbook of Digital Currency, edited by David Lee Kuo Chuen, 45–65. San Diego: Academic Press. https://doi.org/10.1016/B978-0-12-802117-0.00003-5.
Brito, Jerry, and Andrea Castillo. 2016. Bitcoin: A Primer for Policymakers. 2 edition. Arlington, Virginia: Mercatus Center at George Mason University.
D-Cent. 2015. “Tools for Democratic Participation and Citizen Empowerment.” https://dcentproject.eu/wp-content/uploads/2015/10/publishable-summary-10-2015-for-web.pdf.
Gervais, Arthur, Ghassan Karame, and Vedran Capkun. 2015. “Is Bitcoin a Decentralized Currency?” ResearchGate. 2015. https://www.researchgate.net/publication/270802537_Is_Bitcoin_a_Decentralized_Currency.
Halpin, Harry, and Alexandre Monnin. 2014. “Philosophical Engineering: Toward a Philosophy of the Web.” Wiley.Com. 2014. https://www.wiley.com/en-ro/Philosophical+Engineering%3A+Toward+a+Philosophy+of+the+Web-p-9781118700181.
Iansiti, Marco, and Karim R. Lakhani. 2017. “The Truth About Blockchain.” Harvard Business Review, 2017. https://hbr.org/2017/01/the-truth-about-blockchain.
Institute for Blockchain Studies. 2016. “Blockchain Philosophy – Institute for Blockchain Studies Website.” 2016. http://blockchainstudies.org/BlockchainPhilosophy.html.
Lakoff, Johnson, and Mark Johnson. 2003. “Metaphors We Live.” 2003. https://www.press.uchicago.edu/ucp/books/book/chicago/M/bo3637992.html.
Morris, David Z. 2016. “Leaderless, Blockchain-Based Venture Capital Fund Raises $100 Million, And Counting.” Fortune. 2016. http://fortune.com/2016/05/15/leaderless-blockchain-vc-fund/.
Narayanan, Arvind, Joseph Bonneau, Edward Felten, Andrew Miller, and Steven Goldfeder. 2016. Bitcoin and Cryptocurrency Technologies: A Comprehensive Introduction. Princeton University Press.
Nian, Lam Pak, and David Lee Kuo Chuen. 2015. “A Light Touch of Regulation for Virtual Currencies | Request PDF.” ResearchGate. 2015. https://www.researchgate.net/publication/286055684_A_Light_Touch_of_Regulation_for_Virtual_Currencies.
Popper, Nathaniel. 2017. “A Venture Fund With Plenty of Virtual Capital, but No Capitalist.” The New York Times, 2017, sec. Business. https://www.nytimes.com/2016/05/22/business/dealbook/crypto-ether-bitcoin-currency.html.
Swan, Melanie, and Primavera de Filippi. 2017. “Toward a Philosophy of Blockchain: A Symposium: Introduction.” Metaphilosophy 48 (5): 603–619.
Tapscott, Don, and Alex Tapscott. 2016. “Here’s Why Blockchains Will Change the World.” Fortune. 2016. http://fortune.com/2016/05/08/why-blockchains-will-change-the-world/.
Tapscott, Don, Alex Tapscott, and Jeff Cummings. 2017. Blockchain Revolution: How the Technology Behind Bitcoin and Other Cryptocurrencies Is Changing the World. Unabridged edition. Brilliance Audio.
The Economist. 2015. “The Great Chain of Being Sure about Things.” The Economist, 2015. https://www.economist.com/briefing/2015/10/31/the-great-chain-of-being-sure-about-things.
Trottier, Leo. (2013) 2018. Historical Repository of Satoshi Nakamoto’s Original Bitcoin. C++. https://github.com/trottier/original-bitcoin.
WEF Financial Services. 2016. “The Future of Financial Infrastructure. An Ambitious Look at How Blockchain Can Reshape Financial Services. Technical Report, WEF, 2016.” http://www3.weforum.org/docs/WEF_The_future_of_financial_infrastructure.pdf.
Wood, D. 2014. “Ethereum: A Secure Decentralised Generalised Transaction Ledger.” In .
Noțiuni de bază pentru lucrul cu MS Excel: comenzi rapide și sfaturi (previzualizare lipire, comenzi rapide) și formatare de bază (formatarea celulelor, rândurilor și coloanelor prin setarea fișei de lucru / paginii, redimensionarea coloanelor și rândurilor, ascunderea rândurilor și coloanelor, și vizualizarea tipăririi/finalului de pagină).
Acesta este un articol cu Acces Deschis distribuit în conformitate cu termenii licenței de atribuire Creative Commons CC BY 4.0 (http://creativecommons.org/licenses/by/4.0/), care permite utilizarea, distribuirea și reproducerea fără restricții pe orice mediu, cu condiția ca lucrarea originală să fie citată corect.
This is an Open Access article distributed under the terms of the Creative Commons Attribution License CC BY 4.0 (http://creativecommons.org/licenses/by/4.0/), which permits unrestricted use, distribution, and reproduction in any medium, provided the original work is properly cited.
Excel: Comenzi rapide și formatare de bază
Nicolae Sfetcu
Comenzi rapide și sfaturi
Previzualizare lipire
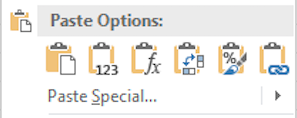
Copiați datele, apoi faceți clic dreapta pe celula în care doriți să o inserați. Dacă treceți peste una dintre pictogramele Lipire opțiune, veți vedea o previzualizare a aspectului datelor. Lipiți o formulă? Vrei doar valoarea celulei? Sa păstrezi aceeași formatare? După ce alegeți, faceți clic pe butonul corespunzător pentru a insera datele.
Comenzi rapide
În plus față de comenzile mai comune, cum ar fi copierea, tăierea, lipirea și salvarea, Excel are o serie de comenzi rapide pe care le veți găsi utile – unele pe care poate le cunoașteți, altele poate că nu!
Pentru a merge în sus și în jos în celule: Enter (jos) sau Shift + Enter (sus) sau tastele săgeată
Pentru a merge la stânga sau la dreapta: Tab (stânga) sau Shift + Tab (dreapta) sau tastele săgeată
Pentru a selecta toate celulele dintr-un rând sau coloană care au date (față de întreaga coloană sau rând): Shift + Command + Arrow (Mac) sau Shift + Control + Arrow (Windows)
Pentru a obține același conținut în mai multe celule, evidențiați celulele, tastați text / număr și apoi apăsați Control + Enter
Utilizați colțul din dreapta jos (Completare automată) a celulei pentru a completa în jos /in sus. Dacă completați in jos o coloană, puteți să faceți, in schimb, dublu clic pe ea (trebuie să fie conținut în celula din stânga acestei celule) (vedeți de mai sus pentru mai multe informații)
Tasta Esc sau X roșu din bara Formula va anula schimbarea.
Utilizați referințe absolute pentru a „bloca” elemente într-o celulă (de exemplu = H2*$I$1) (vedeți mai sus pentru mai multe informații)
Utilizați filtre pentru a vă limita vizualizarea rapidă
Formatare de bază
Formatarea celulelor, rândurilor și coloanelor
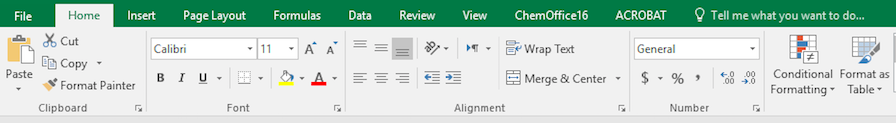
Din meniul Home, puteți formata fontul, numărul, alinierea, bordura, modelul și protecția celulelor, rândurilor și coloanelor.
Puteți, de asemenea, să faceți clic pe pictograma Expand pentru a deschide caseta de dialog Format Cells tradițională care conține file pentru aceste diverse categorii.
Setarea fișei de lucru / paginii
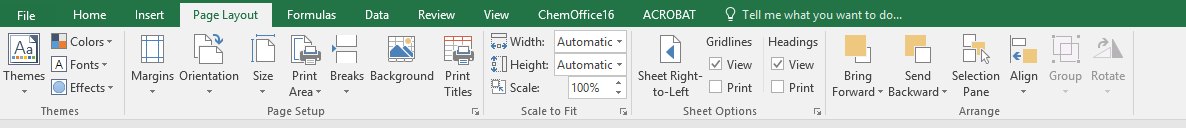
La fel cum meniul Home vă oferă opțiunile care erau accesibile doar în caseta de dialog Format Cells, meniul Page Layout vă oferă acces la caracteristici care erau în caseta de dialog Page Setup (faceți clic pe pictograma Expand pentru a accesa căsuța de dialog tradițională).
În grupul Page Setup, puteți seta marginile, orientarea și zona de tipărire. Rețineți că pictograma Print Titles evocă caseta de dialog Page Setup și că Print Titles aici se referă la titlurile rândurilor și coloanelor (de ex., A, B, C, 1, 2, 3, etc.), nu la anteturile și subsolurile foii. Cu caseta de dialog Page Setup deschisă, puteți face clic pe fila Header/Footer pentru a le schimba. Puteți accesa, de asemenea, anteturile și subsolurile prin intermediul meniului Insert.
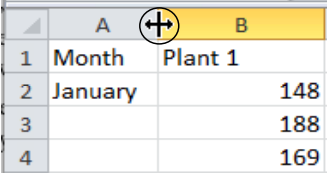
Puteți schimba lățimea unei coloane punând cursorul între literele pentru acea coloană și următoarea. Când obțineți săgeata cu două capete, trageți spre dreapta sau spre stânga, după cum doriți.
Redimensionarea coloanelor și rândurilor
Făcând dublu clic pe același loc va „potrivi automat” coloana, făcând-o la fel de largă ca cea mai mare bucată de text / date din coloana respectivă.
Aceeași tehnică funcționează pentru rânduri; puneți cursorul între cele două numere până când vedeți săgeata cu două capete, apoi trageți sau faceți dublu clic.
Ascunderea rândurilor și coloanelor
Pentru a ascunde o coloană sau un rând, faceți clic dreapta pe litera sau numărul pentru coloana sau rând (A, B, C, etc. sau 1, 2, 3, etc.) și selectați Hide.
Pentru a vedea o coloană sau un rând ascunse, selectați coloanele sau rândurile înainte și după coloana sau rândul lipsă, faceți clic dreapta și selectați Unhide.
Vizualizarea tipăririi/Finalului de pagină
Pentru a vedea unde se vor diviza datele dvs. în mai multe pagini, accesați meniul View și faceți clic pe pictograma Page Break Preview din grupul Workbook Views. Ajustați finalurile de pagină făcând clic și glisând marginile albastre cu mouse-ul. Pentru a reveni la vizualizarea normală, faceți clic pe pictograma Normal.
Taxonomia amenințărilor pentru Big Data este una cuprinzătoare, cu un accent special pe amenințările de securitate cibernetică; adică amenințări care se aplică activelor tehnologiei informației și comunicațiilor. Au fost considerate amenințări suplimentare care nu derivă din TIC pentru a acoperi amenințările asupra bunurilor fizice și, de asemenea, atât dezastrele naturale (care nu sunt declanșate direct de oameni), cât și dezastrele de mediu cauzate direct de oameni.
Cuvinte cheie: securitate, Big Data, megadate, amenințări
Acesta este un articol cu Acces Deschis distribuit în conformitate cu termenii licenței de atribuire Creative Commons CC BY 4.0 (http://creativecommons.org/licenses/by/4.0/), care permite utilizarea, distribuirea și reproducerea fără restricții pe orice mediu, cu condiția ca lucrarea originală să fie citată corect.
This is an Open Access article distributed under the terms of the Creative Commons Attribution License CC BY 4.0 (http://creativecommons.org/licenses/by/4.0/), which permits unrestricted use, distribution, and reproduction in any medium, provided the original work is properly cited.
Securitatea Big Data: Amenințări
Nicolae Sfetcu
Taxonomia amenințărilor
Taxonomia amenințărilor este una cuprinzătoare, cu un accent special pe amenințările de securitate cibernetică; adică amenințări care se aplică activelor tehnologiei informației și comunicațiilor. Au fost considerate amenințări suplimentare care nu derivă din TIC pentru a acoperi amenințările asupra bunurilor fizice și, de asemenea, atât dezastrele naturale (care nu sunt declanșate direct de oameni), cât și dezastrele de mediu cauzate direct de oameni.
Taxonomia amenințărilor a fost dezvoltată de Grupul ENISA Threat Landscape (ETL) și reprezintă o consolidare a amenințărilor luate în considerare anterior în alte rapoarte tematice (1) și cercetări ample. Taxonomia include amenințări aplicabile activelor Big Data și numai acestea sunt descrise în figură. În subsecțiunea următoare, amenințările specifice Big Data care au fost identificate printr-o literatură extinsă, care au fost atribuite categoriilor relevante definite în taxonomia de amenințare a ENISA, sunt mapate la taxonomia activelor Big Data discutate anterior.
Maparea amenințărilor la activele Big Data
Această analiză se bazează pe o analiză extinsă a incidentelor de amenințare reală și a atacurilor la Big Data prezentate în articole, bloguri tehnice, lucrări de conferință, precum și sondaje online pentru colectarea de informații suplimentare. Revizuirea a fost determinată de taxonomia generică a amenințărilor ENISA prezentată în secțiunea anterioară.
În termeni generali, amenințările, precum întreruperea rețelei sau defecțiunile infrastructurii de suport, pot afecta puternic Big Data. De fapt, întrucât un set Big Data are milioane de bucăți de date și fiecare bucată poate fi localizată într-o locație fizică separată, această arhitectură duce la o dependență mai mare de interconectările dintre servere. Rapoartele tematice ENISA anterioare au abordat în profunzime amenințările precum întreruperile și defecțiunile, care afectează legăturile de comunicații în rețea (2). Din acest motiv, aici nu luăm în considerare aceste amenințări. De asemenea, am ales să nu ne oprim asupra atacurilor fizice (deliberate și intenționate), a dezastrelor naturale și de mediu și a eșecurilor / defecțiunilor (de exemplu, disfuncționalități ale infrastructurii de suport TIC), deoarece efectele lor sunt puternic atenuate de redundanța intrinsecă a Big Data, deși proprietarii de Big Data care își instalează sistemele în cloud-uri private sau alte infrastructuri locale ar trebui să ia în considerare aceste atacuri (3).
(Taxonomie de amenințare aplicabilă activelor Big Data)
În general, o amenințare este „orice circumstanță sau eveniment cu potențialul de a avea un impact negativ asupra unui activ prin acces neautorizat, distrugere, divulgare, modificare a datelor și / sau refuz de serviciu” (4). Având în vedere definiția pe care am dat-o despre Big Data (volum, viteză, varietate, veridicitate, variabilitate și valoare), o amenințare la adresa unui activ Big Data poate fi considerată ca orice circumstanță sau eveniment care afectează, adesea simultan, volume mari de date și / sau date din diverse surse și de diferite tipuri și / sau date de mare valoare.
De asemenea, identificăm două sub-categorii diferite de amenințări: breșe („Big Data Breach”) și scurgeri („Big Data Leak”) (5), ortogonal cu taxonomia amenințărilor utilizate. O breșă apare atunci când „un activ de informație digitală este furat de atacatori prin pătrunderea în sistemele sau rețelele TIC în care este deținut / transportat” (6). Putem defini „breșa Big Data” ca furtul unui activ Big Data executat prin pătrunderea în infrastructura TIC. O scurgere de Big Data, pe de altă parte, poate fi definită ca divulgarea (totală sau parțială) a unui activ Big Data într-o anumită etapă a ciclului său de viață. O scurgere de date mari se poate întâmpla, de exemplu, în proiectarea inadecvată, adaptarea software necorespunzătoare, sau atunci când un proces de afaceri eșuează. În ceea ce privește modelul atacatorului, o breșă Big Data necesită un comportament ostil pro-activ (spargerea), în timp ce o scurgere Big Data poate fi exploatată chiar de atacatori cinstiți, dar curioși.
Grupul de amenințări: Daune neintenționate/pierderea informațiilor sau a activelor IT
Acest grup de vulnerabilități include scurgerea de informații sau partajarea din cauza erorilor umane, intervenția neintenționată sau utilizarea eronată a administrării sistemelor (configurare greșită), pierderea dispozitivelor.
Amenințare: Surgerea/partajarea informațiilor din cauza unei erori umane
Amenințările accidentale sunt cele care nu sunt favorizate în mod intenționat de oameni. Acestea se datorează configurării greșite, flisărilor neintenționate și erorilor de scris (de exemplu apăsarea butonului greșit), aplicării greșite a regulilor valide (gestiune slabă a corecțiilor, utilizarea numelor și parolelor implicite de utilizator sau a parolelor ușor de ghicit) și greșelilor bazate pe cunoștințe (actualizări de software și blocări, probleme de integrare, defecte procedurale) (7, 8).
Scurgerea de informații din cauza configurării greșite poate fi o problemă comună: conform unui studiu recent 9, configurațiile eronate de administrare a sistemului au condus la numeroase deficiențe în patru tehnologii diferite de Big Data; adică Redis, MongoDB, Memcache și ElasticSearch. Potrivit aceluiași studiu, majoritatea acestor produse noi „nu sunt menite să fie expuse internetului. […] Setările implicite ale acestor tehnologii tind să nu aibă nicio configurație pentru autentificare, criptare, autorizare sau orice alt tip de controale de securitate pe care le considerăm de la sine înțeles. Unele dintre ele nici măcar nu au un control de acces încorporat.”
Mai mult, în trecut, au fost raportate incidente de partajare inadecvată a fișierelor care conțin posibile informații sensibile și confidențiale, care au afectat chiar și servicii online foarte populare precum Dropbox 10. Acest lucru este confirmat și de multe sondaje 11.
Activele vizate de aceste amenințări includ grupul de active „Date” și activul „Aplicații și servicii back-end” (cum ar fi, de exemplu, „Servicii de facturare”).
Amenințare: Scurgeri de date prin aplicații web (API-uri nesigure)
Diverse surse susțin că Big Data este adesea construită cu puțină securitate 12 13. Noile componente software sunt de obicei furnizate cu autorizare la nivel de serviciu, dar puține utilități sunt disponibile pentru a proteja caracteristicile de bază și interfețele de aplicație (API). Deoarece aplicațiile Big Data sunt construite pe modele de servicii web, API-urile pot fi vulnerabile la atacuri binecunoscute, cum ar fi lista Top Ten Open Web Application Security Project (OWASP) 14, cu puține facilități pentru contracararea amenințărilor web comune.
Vânzătorul de software de securitate Computer Associate (CA) 15 și alte surse 16 raportează încălcări ale datelor, din cauza API-urilor nesigure, în multe industrii, în special în rețelele sociale, în serviciile mobile de partajare a fotografiilor și video, precum Facebook, Yahoo și Snapchat.
De exemplu, o amenințare a acestei categorii poate consta în atacuri prin injectare la tehnologiile Web semantic prin injectarea codului SPARQL 17. Vulnerabilitățile de securitate sunt destul de comune în noile limbaje Big Data, cum ar fi SPARQL, RDQL (ambele sunt limbaje de interogare doar pentru citire) și SPARUL (sau SPARQL/Update, care are capabilități de modificare). Utilizarea acestor noi limbaje de interogare introduce vulnerabilități deja găsite la o utilizare proastă a limbajelor de interogare de stil vechi, deoarece atacurile precum injectarea SQL, LDAP și XPath sunt deja bine cunoscute și încă periculoase 18. Bibliotecile acestor noi limbaje oferă instrumente pentru a valida intrarea utilizatorului și pentru a minimiza riscul. Cu toate acestea, „bibliotecile principale de limbaj de interogare ontologic încă nu oferă niciun mecanism pentru a evita injectarea de cod” și fără aceste mecanisme, arsenalul atacatorilor ar putea fi îmbunătățit cu injecții SPARQL, RDQL și SPARQL 19. Alte noi produse software Big Data, cum ar fi Hive, MongoDB și CouchDB, suferă, de asemenea, de amenințări tradiționale, cum ar fi execuția de cod și injecția SQL de la distanță 20.
Activele vizate de aceste amenințări aparțin grupului „Date” și tipului de active „Modele de infrastructură de stocare” (cum ar fi „Sisteme de management al bazelor de date (DBS)” și „Instrumente web semantic”).
Amenințare: Proiectare și planificare inadecvate sau adaptare incorectă
Tehnicile de îmbunătățire a performanței analizei Big Data și fuziunea surselor de date eterogene cresc redundanța ascunsă a reprezentării datelor, generând copii prost protejate. Acest lucru provoacă tehnicile tradiționale de protejare a confidențialității 21 și trebuie luat în considerare efectul redundanței. După cum s-a menționat deja, redundanța Big Data poate fi văzută ca o tehnică de atenuare a amenințărilor pentru atacuri fizice, dezastre și întreruperi 22, totuși, în unele cazuri, semnalează o slăbiciune a sistemului, fiind un stimulent de risc pentru scurgerile de Big Data. Cu alte cuvinte, dacă stocarea noastră Big Data replică înregistrările de date de zece ori și distribuie copiile la zece noduri de stocare dintr-un motiv oarecare (de exemplu, pentru a accelera conducta de analiză), cele zece noduri pot ajunge la niveluri diferite de robustețe a securității (de ex. , diferite versiuni de software de securitate) și acest lucru va crește probabilitatea dezvăluirii datelor și a scurgerilor de date. Aceasta poate fi considerată o slăbiciune specifică a designurilor Big Data.
Pe de altă parte, putem observa că chiar și redundanța și replicarea, care sunt caracteristici necesare pentru a îmbunătăți funcționalitatea Big Data, nu sunt întotdeauna sigure împotriva pierderii datelor. De exemplu, Hadoop, binecunoscutul cadru pentru procesarea Big Data, replică datele de trei ori în mod implicit, deoarece acest lucru protejează împotriva defecțiunilor inevitabile ale hardware-ului de bază. Cu toate acestea, o aplicație coruptă ar putea distruge toate replicările de date 23. De asemenea, studii recente au prezentat ideea că redundanța Hadoop ar putea fi chiar un stimulent neliniar de risc pentru scurgerile de megadate (big data) 24.
Chiar și designul sistemului de fișiere distribuit Hadoop (HDFS) semnalează probleme așa cum este raportat de literatură 25. HDFS stă la baza multor sisteme de stocare pe scară largă a Big Data și este folosit de rețelele sociale. Clienții HDFS efectuează operațiuni de metadate ale sistemului de fișiere printr-un singur server cunoscut sub numele de Namenode și trimit și recuperează datele sistemului de fișiere prin comunicare cu un grup de noduri. Pierderea unui singur nod nu ar trebui să fie niciodată fatală, dar pierderea Namenode-ului nu poate fi tolerată 26. Rețelele sociale mari, precum Facebook, au suferit această problemă și au luat contramăsuri împotriva amenințării 27 (Hadoop instalat la Facebook include unul dintre cele mai mari clustere HDFS unice, mai mult de 100 PB de spațiu pe disc fizic într-un singur sistem de fișiere HDFS).
O altă amenințare legată de design este lipsa de scalabilitate a unor instrumente. De exemplu, NIST raportează că tehnicile originale de gestionare a drepturilor digitale (DRM) nu au fost construite pentru a fi la scară și pentru a satisface cerințele pentru utilizarea prognozată a datelor și „DRM-ul poate eșua să funcționeze în medii cu caracteristici Big Data – în special viteza și volumul agregat” 28 29.
Activele care sunt vizate de aceste amenințări aparțin grupurilor de active „Date” și „Analitica Big Data” și tipurilor de active „Software”, „Modele de infrastructură de calcul” și „Modele de infrastructură de stocare”.
Grupul de amenințări: ascultarea clandestină, interceptarea și hijacking
Acest grup include amenințările care se bazează pe alterarea/manipularea comunicațiilor dintre două părți. Aceste atacuri nu necesită instalarea de instrumente sau software suplimentare pe infrastructura victimelor.
Amenințare: Interceptarea informațiilor
O problemă comună care afectează orice infrastructură TIC este atunci când infractorii pot intercepta comunicațiile între noduri țintind legăturile de comunicație. Diverse surse susțin că comunicarea între noduri cu noile instrumente Big Data este adesea nesecurizată (30), că nu este dificil să deturnezi o sesiune de utilizator sau să obții acces neautorizat la servicii din rețelele sociale precum Facebook și Twitter (31) și că există dovezi ale unor defecte în protocoalele de comunicare. (32)
Distribuțiile de software Big Data (de exemplu Hadoop, Cassandra, MongoDB (33), Couchbase) rareori au protocoalele care asigură confidențialitatea și integritatea datelor între aplicațiile care comunică (de exemplu, TLS și SSL) activate implicit sau configurate corect (de exemplu, schimbarea parolelor implicite).
Activele vizate de această amenințare aparțin grupurilor de active „Date” și „Roluri” și activului „Aplicații și servicii back-end”.
Grupul de amenințări: Activități/abuzuri nefaste
Acest grup include amenințările care provin din activități nefaste. Spre deosebire de grupul anterior, aceste amenințări impun (deseori) atacatorului să efectueze unele acțiuni care modifică infrastructura TIC a victimelor; de obicei cu utilizarea unor instrumente și software specifice.
Amenințare: Fraudarea identității
Sistemele Big Data stochează și gestionează acreditările pentru accesarea datelor personale și a conturilor financiare cu informații precum numerele cardurilor de credit și detaliile de plată și facturare, care sunt ținte pentru criminalii cibernetici. Sistemele Big Data stochează, de asemenea, date de profilare care pot descrie comportamentul utilizatorului, preferințele, obiceiurile, călătoriile, consumul de media la un grad ridicat de detaliu, și pot ajuta atacatorii în forme mai elaborate de fraudă prin uzurparea identității, creând oportunități mari pentru hoții de identitate (34).
Deoarece majoritatea sistemelor Big Data sunt construite peste infrastructura cloud, o amenințare la adresa identității utilizatorilor este, de exemplu, atunci când se pierde controlul unei interfețe de sistem, fie într-un sistem Big Data bazat pe un cloud public mare, fie într-un cloud privat larg utilizat (35). Un atac reușit asupra unei console oferă atacatorului putere completă asupra contului victimei, inclusiv asupra tuturor datelor stocate. Interfețele de control ar putea fi inițial compromise prin împachetarea semnăturii noi și tehnici avansate XSS, apoi escaladarea privilegiilor poate duce la fraudă de identitate (36). În timp ce în sistemele informaționale tradiționale pierderea controlului unei interfețe de consolă ar putea cauza scurgeri limitate de informații, în Big Data efectul este amplificat și impactul este mai sever.
Ingineria socială nu este o problemă nouă, dar pe măsură ce rețelele sociale devin importante atât pentru utilizatorii casnici cât și pentru companii, atacurile implică adesea ingineria socială. Atacatorii au abuzat de rețelele sociale de când au apărut pentru prima dată pe internet. De exemplu, vulnerabilitățile XSS de pe Twitter au fost folosite pentru a trimite tweet-uri rău intenționate și false, în timp ce malware-ul de internet a apărut pe Facebook ca mijloc de promovare a profilurilor rău intenționate (37).
Activele vizate de aceste amenințări sunt „Informații personale de identificare”, „Aplicații și servicii back-end” (cum ar fi, de exemplu, „Servicii de facturare”) și „Servere”.
Grupul de amenințare: Legale
Acest grup include amenințări datorate implicațiilor legale ale unui sistem Big Data, cum ar fi încălcarea legilor sau reglementărilor, încălcarea legislației, nerespectarea cerințelor contractuale, utilizarea neautorizată a resurselor de proprietate intelectuală, abuzul de date cu caracter personal, necesitatea supunerii hotărârilor judecătorești și de tribunal.
Amenințare: Încălcarea legilor sau reglementărilor / Încălcarea legislației / Abuzul de date cu caracter personal
Stocarea datelor în Uniunea Europeană intră sub incidența directivei privind protecția datelor: organizațiile sunt obligate i) să adere la această lege de conformitate pe toată durata de viață a datelor, ii) să rămână responsabile pentru datele cu caracter personal ale clienților și angajaților lor și iii) să garanteze securitatea chiar și atunci când o terță parte, cum ar fi un furnizor de cloud, prelucrează datele în numele lor.
În modelul tradițional centrat pe date, datele sunt stocate la nivel local și fiecare organizație are control asupra informațiilor. În schimb, în Big Data, apare o preocupare reală cu privire la securitatea acestei cantități masive de informații digitale și protecția infrastructurii critice care o susține, așa cum demonstrează o vastă literatură despre riscurile de confidențialitate (38) (39) (40) (41).
De asemenea, trebuie menționat că UE are reglementări mai stricte în ceea ce privește colectarea datelor cu caracter personal decât alte țări, dar uneori multinaționalele care operează în UE au sediul în Statele Unite. În acest context, cele mai importante probleme de confidențialitate sunt modul de protejare a confidențialității individuale atunci când datele sunt stocate pe mai multe site-uri și cât de eficientă este protecția la.
Big Data ridică, de asemenea, potențiala problemă a rezidenței datelor (42). Datele, atunci când sunt stocate în stocarea cloud a furnizorilor care oferă soluții de stocare multinaționale, pot intra în jurisdicții legale diferite. Un exemplu adus de NIST Big Data Public Working Group se referă la custodia datelor farmaceutice dincolo de dispozițiile de testare, care este neclară, mai ales după fuzionarea sau dizolvarea firmelor (43).
Activele vizate de această amenințare includ grupuri de active „Date” (în special „date de înregistrare de identificare”) și „Roluri”.
Grup de amenințări: Amenințări organizaționale
Acest grup include amenințările care țin de sfera organizațională.
Amenințare: Lipsa de calificare
Analiza seturilor mari de date poate susține noi valuri de creștere a productivității și inovației și poate debloca o valoare semnificativă. Cu toate acestea, companiile și factorii de decizie politică trebuie să abordeze obstacole semnificative, cum ar fi, de exemplu, o posibilă lipsă de oameni de știință de date și manageri calificați (44).
Activul vizat de această amenințare este grupul de active „Roluri”.
Referințe
(1) Smart Grid Threat Landscape, Threat Landscape and Good Practice Guide for Internet Infrastructure, Threat Landscape and Good Practice Guide for Smart Home and Converged Media
(2) ENISA, „Threat Landscape and Good Practice Guide for Internet Infrastructure”, ianuarie 2015
(3) Trebuie să menționăm că unele instalații Big Data de bază, de testare sau cu scop special, ar putea să nu se bazeze, total sau parțial, pe redundanță [cloud]. De exemplu, Big Data instalat într-un mediu cloud privat, fără servicii de replicare activate, nu are opțiune de recuperare în caz de dezastru natural. Fiind limitate la un mediu privat de cloud local, aceste instalații ar putea fi, în principiu, supuse unor atacuri fizice și dezastre naturale și de mediu, cum ar fi cutremure, inundații, alunecări de teren, tsunami, incendii, poluare, praf, tunete și alte evenimente majore. pentru mediu. Cu toate acestea, activarea serviciilor private de replicare în cloud între diferite locații fizice diminuează acest risc.
(4) A se vedea glosarul din https://www.enisa.europa.eu/activities/risk-management/current-risk/risk-management-inventory/glossary, accesat în decembrie 2015.
(5) E. Damiani, „Toward Big Data Leak Analysis”. Proceedings of Privacy and Security of Big Data Workshop (PSBD 2015), IEEE Big Data Conference, San Jose, CA, 1-3 noiembrie 2015
(6) A se vedea modelul ISO 15408.
(7) A se vedea taxonomia erorii umane în sistemele informaționale în Im și Richard L. Baskerville (Georgia State University), „A Longitudinal Study of Information System Threat Categories: The Enduring Problem of Human Error”. ACM SIGMIS (2005).
(8) Conform „IBM Security Services 2014 Cyber Security Intelligence Index” peste 95% din toate incidentele investigate recunosc „eroarea umană” și cea mai răspândită eroare umană este„Dublu clic” pe un atașament infectat sau pe o adresă URL nesigură.
(9) BinaryEdge, o firmă de inginerie de securitate cu sediul în Elveția, a investigat patru tehnologii obișnuite de Big Data, cum ar fi Redis, MongoDB, Memcache și Elasticsearch și a găsit diverse probleme de configurare. De exemplu, compania a descoperit că zeci de mii de instanțe de baze de date NoSQL erau accesibile fără a fi necesară autentificarea. A se vedea http://blog.binaryedge.io/2015/08/10/data-technologies-and-security-part-1/, accesat în decembrie 2015.
(10) Techcrunch, un editor online popular de știri din industria tehnologiei, a raportat că la Dropbox, pentru o perioadă scurtă de timp, serviciul a permis utilizatorilor să se conecteze la conturi folosind orice parolă. Cu alte cuvinte, oamenii se puteau conecta la contul cuiva doar introducând adresa lor de e-mail. Consultați http://techcrunch.com/2011/06/20/dropbox-security-bug-made-passwords-optional-for-four-hours/, accesat în decembrie 2015.
(11) Marea majoritate (mai mult de 80%) a participanților la raportul EMA Research din 2015 privind securitatea colaborării cu fișierele, sponsorizat de FinalCode, au recunoscut că au existat incidente de scurgere de date în organizațiile lor. Consultați http://www.finalcode.com/en/how-it-works/resources/ema-report/, accesat în decembrie 2015.
(12) Securing Big Data: Security Recommendations for Hadoop and NoSQL Environments, publicat de compania de securitate Securosis, în octombrie 2012, https://securosis.com/assets/library/reports/SecuringBigData_FINAL.pdf, accesat în decembrie 2015.
(13) Eduardo B. Fernandez (Departamentul de Calcul și Inginerie Electronică și Știința Calculatoarelor, Florida Atlantic University), „Security in Data Intensive Computing Systems in Handbook of Data Intensive Computing”. Springer (2011), http://link.springer.com/chapter/10.1007/978-1-4614-1415-5_16, accesat în decembrie 2015.
(14) Multe expuneri comune la vulnerabilități pentru componentele Big Data, cum ar fi Hadoop, sunt raportate pe site-uri web specializate, a se vedea, de exemplu, https://cve.mitre.org și https://www.cvedetails.com, accesate în decembrie 2015.
(15) Jaime Ryan (CA, Director Sr.) și Tyson Whitten (CA, Director of API Management) în prezentarea și webinarul „Takeaways from API Security Breaches” (2015) au raportat încălcări, din cauza API-urilor nesecurizate, pentru Yahoo, Snapchat și alte companii , consultați http://transform.ca.com/API-security-breaches.html?source=AAblog, accesat în decembrie 2015.
(16) A se vedea problemele de securitate pentru biblioteca Graph Facebook API raportate de blogul tehnic Websegura, http://www.websegura.net/advisories/facebook-rfd-and-open-file-upload/, accesat în decembrie 2015.
(17) A se vedea http://www.morelab.deusto.es/code_injection/ și următoarea publicație: Pablo Orduña, Aitor Almeida, Unai Aguilera, Xabier Laiseca, Diego López-de-Ipiña, Aitor Gómez-Goiri, „Identifying’Identifying Security Issues in the Semantic Web: Injection attacks in the Semantic Query Languages“, [VI Jornadas Científico-Técnicas en Servicios Web y SOA (JSWEB 2010p.)], Valencia, Spania. Septembrie 2010, p. 43 – 50. ISBN: 978-84-92812-59-2.
(18) În octombrie 2015, probabil, o injecție SQL a fost folosită pentru a ataca serverele companiei britanice de telecomunicații Talk Talk’s, punând în pericol detaliile personale a până la patru milioane de clienți. A se vedea http://www.mobilenewscwp.co.uk/2015/10/23/talktalk-hacking-scandal-expert-reaction/, accesat în decembrie 2015.
(19) Ben Mustapha et al., „Enhancing semantic search using case-based modular ontology”. în Proceeding of the 2010 ACM Symposium on Applied Computing.
(20) De exemplu, versiunea 2.0 Hive suferă de criptare încrucișată, execuție de cod și vulnerabilități de injectare SQL la distanță, consultați https://packetstormsecurity.com/files/132136/Hive-2.0-RC2-XSS-Code-Execution-SQL-Injection. html. MongoDB suferă atacuri prin injecție, vezi https://www.idontplaydarts.com/2011/02/mongodb-null-byte-injection-attacks/. Vedeți și alte amenințări specifice furnizorului în prezentare https://www.defcon.org/images/defcon-21/dc-21-presentations/Chow/DEFCON-21-Chow-Abusing-NoSQL-Databases.pdf, accesat în decembrie 2015.
(21) E. Damiani, „Toward Big Data Risk Analysis”, Discurs principal la cel de-al 2-lea Atelier internațional de confidențialitate și securitate a datelor mari (PSBD 2015)
(22) Atacurile fizice, dezastrele și, respectiv, întreruperile sunt descrise ca grup de amenințări în taxonomia generică a amenințărilor ENISA.
(23) A se vedea http://www.smartdatacollective.com/michelenemschoff/193731/how-your-hadoop-distribution-could-lose-your-data-forever, accesat în decembrie 2015.
(24) E. Damiani, „Toward Big Data Leak Analysis”, Proceedings of the Privacy and Security of Big Data Workshop (PSBD 2015), IEEE Big Data Conference, San Jose, CA, 1-3 noiembrie 2015
(25) Aditham, Ranganathan (Departamentul de Informatică și Inginerie, Universitatea din Florida de Sud, Tampa, SUA), „A Novel Framework for Mitigating Insider Attacks in Big Data Systems”. 2015 IEEE International Conference on Big Data
(26) Toate operațiunile cu metadate trec prin Namenode. Dacă Namenode nu este disponibil, niciun client nu poate citi sau scrie pe HDFS, iar utilizatorii și aplicațiile care depind de HDFS nu vor putea funcționa corect. Versiunile recente de Hadoop au introdus și alte componente pentru gestionarea resurselor pentru a rezolva această problemă.
(27) A se vedea „Notes by Facebook engineering” în https://www.facebook.com/notes/facebook-engineering/under-the-hood-hadoop-distributed-filesystem-reliability-with-namenode-and-avata/10150888759153920. Facebook a contribuit la o soluție funcțională pentru a rezolva deficiențele arhitecturale ale failoverului unic Namenode, numit Avatarnode. Acesta este un modul cu sursă deschisă care oferă failover și failback la cald și este acum în producție la Facebook, rulând cel mai mare cluster Hadoop Data Warehouse (100 PB spațiu pe disc fizic într-un singur sistem de fișiere HDFS).
(28) A se vedea NIST Special Publication 1500-4. Use case: consumer digital media (exemple: Netflix, iTunes și altele).
(29) Xiao Zhang, „A Survey of Digital Rights Management Technologies”, vezi http://www.cse.wustl.edu/~jain/cse571-11/ftp/drm.pdf, accesat în decembrie 2015.
(30) Securing Big Data: Security Recommendations for Hadoop and NoSQL Environments, publicată de compania de securitate Securosis, L.L.C., 12 octombrie 2012.
(31) A se vedea, de exemplu, „How to prevent a session hijacking attack” in Facebook și Twitter, http://searchmidmarketsecurity.techtarget.com/tip/Defending-against-Firesheep-How-to-prevent-a-session-hijacking-attack, accesat în decembrie 2015.
(32) A se vedea, de exemplu, un atac împotriva confidențialității datelor aflate în tranzit prin rețelele nesigure în http://www.isg.rhul.ac.uk/tls/Lucky13.html, accesat în decembrie 2015.
(33) A se vedea, de exemplu, documentația MongoDB despre aceasta și greșelile care pot compromite baza de date (erori de configurare TTL și altele), http://blog.mongodb.org/post/87691901392/mongodb-security-part-ii-10-mistakes- that-can, accesat în decembrie 2015.
(34) Big data creează mari oportunități pentru hoții de identitate: a se vedea http://www.c4isrnet.com/story/military-tech/it/2015/01/19/big-data-identity-theft/22004695/, accesat în decembrie 2015.
(35) A se vedea: J. Somorovsky et al., „All your clouds belong to us: security analysis of cloud management interfaces”, în Proceedings of the 3rd ACM workshop on Cloud computing security workshop (http://dl.acm.org/citation.cfm?id=2046664) pentru atacuri la Amazon și Eucalyptus. Lucrarea oferă o analiză de securitate a interfețelor de control ale serviciilor Cloud publice mari (Amazon EC2 și S3) și software-ului Cloud privat (Eucalyptus).
(36) A se vedea http://www.zdnet.com/article/us-cert-warns-of-guest-to-host-vm-escape-vulnerability/. Articolul descrie o vulnerabilitate, care afectează sistemele de operare pe 64 de biți și software-ul de virtualizare care rulează pe hardware CPU Intel și expune utilizatorii la atacuri locale de escaladare a privilegiilor sau la o evadare de la o mașină virtuală de la oaspete la gazdă.
(37) A se vedea Nine Threats Targeting Facebook Users în http://www.itbusinessedge.com/slideshows/show.aspx?c=90875, accesat în decembrie 2015.
(38) Venkat N. Gudivada (Universitatea Marshall), Ricardo Baeza-Yates (Laboratoarele Yahoo), Vijay V. Raghavan (Universitatea din Louisiana), „Big Data: Promises and Problems”, Numărul nr.03, 2015, publicat de IEEE Computer Societate. Consultați http://www.computer.org/csdl/mags/co/2015/03/mco2015030020.html. Cartea afirmă că „veridicitatea – datorită prelucrării intermediare, diversității între sursele de date și în evoluția datelor ridică îngrijorări cu privire la securitate, confidențialitate, încredere și responsabilitate, creând necesitatea de a verifica proveniența securizată a datelor”.
(39) White House Big Data Report, publicat la 1 mai 2014. A se vedea https://www.whitehouse.gov/sites/default/files/docs/big_data_privacy_report_may_1_2014.pdf, accesat în decembrie 2015.
(40) A se vedea diverse exemple date de Raymond Chi-Wing Wong, „Big Data Privacy”, în Journal of Information Technology & Software Engineering, Department of Computer Science and Engineering, Hong Kong University of Science and Technology, China, http://www. omicsgroup.org/journals/big-data-privacy-2165-7866.1000e114.php?aid=10289. Articolul citează diferite cazuri de utilizare: (i) datele persoane ale unui set de date medicale au fost identificate din cauza protecției insuficiente a confidențialității, (ii) seturi de date, inclusiv jurnalele de căutare, au fost eliberate de un furnizor de internet american, dar a fost posibil să se identifice o persoană folosind mai multe persoane- interogări specifice, (iii) un serviciu popular de închiriere de filme online cu un sistem de recomandare, filme propuse clienților săi pe baza preferințelor lor de film anticipate, cu toate acestea, aproape toți abonații ar putea fi identificați în mod unic, (iv) mulți clienți de telefonie mobilă folosind bazate pe locație serviciile (LBS) au avut serioase preocupări legate de confidențialitate cu privire la dezvăluirea locațiilor lor împreună cu informațiile lor personale.
(41) S. De Capitani di Vimercati, S. Foresti, P. Samarati, „Managing and Accessing Data in the Cloud: Privacy Risks and Approaches”, în Proc. of the 7th International Conference on Risks and Security of Internet and Systems (CRiSIS 2012), Cork, Irlanda.
(42) Vezi Storing Data In The Cloud Raises Compliance Challenges în http://www.forbes.com/sites/ciocentral/2012/01/19/storing-data-in-the-cloud-raises-compliance-challenges/, accesat în decembrie 2015.
(43) A se vedea NIST Special Publication 1500-4. Use case: Pharmaceutical clinical trial data sharing.
(44) A se vedea, de exemplu, rapoarte de la McKinsey http://www.mckinsey.com/features/big_data și de la Financial Times http://www.ft.com/cms/s/0/953ff95a-6045-11e4-88d1-00144feabdc0 .html#axzz3ntU3lM00, accesat în decembrie 2015.
Când spunem că unele date sunt „atomice” în limbajul de programare Python, nu înseamnă că sunt radioactive; vrem să spunem că sunt indivizibile.
Anticii vorbeau despre „atomi” drept cele mai mici bucăți posibile de materie. Dacă împărțiți orice obiect fizic – să zicem, un măr – în părți, obțineți componentele sale: o tulpină, pielița, semințe și miezul dulce și suculent. Tăiați oricare dintre aceste bucăți cu un cuțit și veți obține bucăți mai mici. Dacă continuați să le divizați din ce în ce mai mult, filozofii precum Democrit au argumentat că veți ajunge în cele din urmă la mici biți indivizibili care nu mai pot fi divizați în continuare. Aici se află lumea fizică la cel mai înalt grad de granularitate.
În mod similar, o piesă de date atomice este tratată de obicei ca o unitate întreagă, nu ca ceva cu structură internă care poate fi defalcată. Există diferite moduri în care acești atomi de date pot fi strânși împreună și organizați în ansambluri mai mari.
Acesta este un articol cu Acces Deschis distribuit în conformitate cu termenii licenței de atribuire Creative Commons CC BY 4.0 (http://creativecommons.org/licenses/by/4.0/), care permite utilizarea, distribuirea și reproducerea fără restricții pe orice mediu, cu condiția ca lucrarea originală să fie citată corect.
This is an Open Access article distributed under the terms of the Creative Commons Attribution License CC BY 4.0 (http://creativecommons.org/licenses/by/4.0/), which permits unrestricted use, distribution, and reproduction in any medium, provided the original work is properly cited.
Tipuri de date atomice în Python
Stephen Davies
Date atomice
Când spunem că unele date sunt „atomice”, nu înseamnă că sunt radioactive; vrem să spunem că sunt indivizibile.
Anticii vorbeau despre „atomi” drept cele mai mici bucăți posibile de materie. Dacă împărțiți orice obiect fizic – să zicem, un măr – în părți, obțineți componentele sale: o tulpină, pielița, semințe și miezul dulce și suculent. Tăiați oricare dintre aceste bucăți cu un cuțit și veți obține bucăți mai mici. Dacă continuați să le divizați din ce în ce mai mult, filozofii precum Democrit au argumentat că veți ajunge în cele din urmă la mici biți indivizibili care nu mai pot fi divizați în continuare. Aici se află lumea fizică la cel mai înalt grad de granularitate.
În mod similar, o piesă de date atomice este tratată de obicei ca o unitate întreagă, nu ca ceva cu structură internă care poate fi defalcată. Există diferite moduri în care acești atomi de date pot fi strânși împreună și organizați în ansambluri mai mari.
Medii și variabile
Un program de analiză a datelor folosește un mediu pe măsură ce rulează. „Mediu” înseamnă doar „toate datele care sunt vizualizate în prezent și pe care programul le poate accesa.” (1) Mediul este format din variabile, fiecare (de obicei) având un nume și o valoare. De exemplu, s-ar putea să avem o variabilă numită vârstă a cărei valoare este 21 și o variabilă numită slogan a cărei valoare este „Unu pentru toți și toți pentru unu”.
Fiecare variabilă din mediu trebuie să aibă un nume distinct (adică, nu există două variabile care să poarte același nume). De asemenea, important, motivul pentru care aceste elemente de bază sunt numite „variabile” este că valoarea lor se poate schimba pe măsură ce programul se execută. Deși putem crea inițial o variabilă age cu valoarea 21, mai târziu în program, valoarea variabilei s-ar putea schimba la 22, sau 50 sau 0. Numele variabilei nu se schimbă niciodată.
Tipuri de date atomice
Există un alt lucru pe care o variabilă îl are pe lângă numele și valoarea sa: un tip. (2) Într-un limbaj de programare precum Python, fiecare bucată de date are un tip specific, care este necesar pentru a determina cum se comportă și tot ce puteți face cu ea. O întrebare pe care ar trebui să o pui mult este: „bine, am o variabilă în mediul meu numită x … acum care este tipul ei?” Este posibil să fi ghicit (corect) că variabilele noastre de vârstă și slogan din secțiunea anterioară sunt de diferite tipuri: una este un număr, iar cealaltă este o frază.
Există trei tipuri principale de date atomice.
Numere întregi
Un tip foarte comun de date sunt numerele întregi sau întregii. Acestea sunt de obicei pozitive, dar pot fi și negative, și nu au nicio zecimală. Lucruri precum anul nașterii unei persoane, votul total al unui candidat sau numărul de „aprecieri” al unei postări pe rețelele sociale sunt reprezentate cu acest tip de date.
Numere reale (fracționale)
Vă puteți aminti din matematica liceului că așa-numitele „numere reale” includ nu numai numere întregi, ci și numere cu cifre după virgula zecimală. Prin urmare, acest tip poate fi utilizat pentru a stoca ratele dobânzilor, citirile de temperatură și ratingurile medii ale filmelor pe o scară de la 1 la 5.
Deoarece toate numerele întregi sunt numere reale, s-ar putea să vă întrebați de ce ne deranjăm să definim două tipuri diferite pentru acestea. De ce să nu dai doar ambelor tipuri de variabile același tip, de număr real? Practic, răspunsul este că ceva „se simte a fi greșit” în acest sens pentru comunitatea științei datelor. Un utilizator Facebook ar putea avea 240 de prieteni sau 241, dar niciodată nu ar avea sens să aibă 240,3 prieteni. A apărut astfel un consens: variabilele care ar stoca numai numere întregi ar trebui să fie într-adevăr de un tip dedicat doar numerelor întregi. Puteți încălca această convenție, dar veți fi considerat ciudat de colegii dvs. dezvoltatori dacă faceți acest lucru.
Text
În cele din urmă, unele valori care nu sunt deloc numerice, cum ar fi numele unui client, titlul emisiunii sau un tweet. Deci, al treilea tip de date este textual. Variabilele de acest tip au o secvență de caractere ca valori. Aceste caractere sunt de cele mai multe ori litere, dar pot include și spații, punctuație și caractere din alte alfabete.
Apropo, acest al treilea tip de date se poate îndrepta până la linia „atomică” și uneori o poate traversa. Cu alte cuvinte, vom lucra ocazional cu valorile textului non-atomic, împărțindu-le în cuvintele lor constitutive sau chiar în litere. De cele mai multe ori, totuși, vom trata o secvență de caractere precum „Avengers: Endgame” ca o singură bucată de date indivizibilă în același mod în care tratăm un număr ca 42.
Dar ce zici de …?
Ce se întâmplă cu alte lucruri pe care le poate stoca un computer: fișiere de imagini, melodii, videoclipuri? Se pare că, prin trucuri inteligente, toate aceste tipuri de suporturi și multe altele pot fi reduse la un număr mare de numere întregi, și stocate într-o structură de date cumulată. La nivel atomic, rămân cele trei tipuri prezentate mai sus.
Cele trei tipuri în Python
Cele trei tipuri obișnuite de date atomice descrise mai sus sunt în limbaj general: aceasta înseamnă că sunt conceptuale, nu sunt legate de niciun limbaj de programare specific sau instrument de analiză. Orice tehnologie utilizată pentru știința datelor va avea capacitatea de a face față acestor trei tipuri de bază. Modalitățile specifice în care fac acest lucru vor diferi oarecum de la o limbă la alta. Să aflăm cum le implementează Python.
Numere întregi: int
Unul dintre cele mai de bază tipuri de date Python este „int”, care înseamnă „întreg”. Este ceea ce folosim pentru a reprezenta numerele întregi.
În Python, creați o variabilă prin simpla tastare a numelui său, a unui semn egal și apoi a valorii sale inițiale, astfel:
revolution = 1776
Aceasta este prima noastră linie de cod (3). După cum vom vedea, liniile de cod sunt executate una câte una – există un timp înainte și un timp după, fiecare linie este efectiv executată. Acest lucru se va dovedi a fi foarte important. (Oh, iar o „linie de cod” este uneori numită și o instrucțiune.)
Numele variabilelor Python pot fi cât de lungi doriți, cu condiția să fie alcătuite doar din litere mari și mici, cifre și caractere de subliniere. (Trebuie să fiți în concordanță cu scrierea dvs. cu majuscule și cu ortografiia dvs.: nu puteți apela o variabilă Movie într-o linie de cod și movie în alta.) Sublinierile (undersore) sunt adesea folosite ca pseudo-spații, dar nu sunt permise alte semne de punctuație ciudate în numele unei variabile. (4)
Și întrucât suntem la subiect, permiteți-mi să vă încurajez să vă numiți bine variabilele. Aceasta înseamnă că fiecare nume de variabilă ar trebui să reflecte exact ceea ce reprezintă valoarea pe care o stochează. Exemplu: dacă o variabilă este menită să stocheze ratingul (în „stele”) pe care un utilizator IMDB l-a acordat unui film, nu o denumiți movie. Denumiți-o rating. (Sau chiar mai bine, movie_rating.) Credeți-mă: atunci când lucrezi la un program complex, există suficiente lucruri grele la care să te gândești fără să te încurci pe tine (și colegii tăi) prin nume de variabile apropiate, dar nu exacte. (5)
Acum amintiți-vă că o variabilă are trei lucruri – un nume, o valoare și un tip. Primele două apar în mod explicit în linia de cod în sine. În ceea ce privește tipul, de unde știe Python că revolution ar trebui să fie un „int?” Simplu: este un număr fără punct zecimal.
Ca o verificare a corectitudinii, putem cere lui Python să ne spună în mod explicit tipul variabilei, scriind acest cod:
type(revolution)
Dacă această linie de cod este executată după executarea celei anterioare, Python răspunde cu:
▌int
Deci, asta e.
Iată un alt „fragment de cod” (“code snippet” un termen care înseamnă doar „unele linii de cod pe care mă concentrez, care sunt, în general, doar o parte a unui program mai mare”):
Acum, dacă aceasta ar fi o clasă de matematică, acel set de ecuații ar fi absurd. Cum ar putea aceeași variabilă (revolution) să aibă două valori contradictorii? Dar într-un program, acest lucru este perfect legitim: înseamnă doar că imediat după executarea primei linii de cod, revolution are valoarea 1776, iar câteva momente mai târziu, după executarea celei de-a treia linii, valoarea sa s-a schimbat la 1917. Valoarea sa depinde în întregime de „pe unde este programul” în timpul execuției sale.
Numere reale (fracționale): float
Singurul lucru ciudat despre al doilea tip de date din Python este numele său. În alt univers, s-ar fi putut numi o variabilă „reală” sau „zecimală” sau „fracționată”, dar din anumite motive istorice bizare este numită float. (6)
Toate aceleași reguli și reglementări se referă la float, la fel ca la int; singura diferență este că tastați un punct zecimal. Astfel:
Rețineți că variabila interest_rate este într-adevăr un tip float (chiar dacă nu are parte fracțională) deoarece am tastat o perioadă:
type(interest_rate)
▌float
Text: str
Vorbind de nume ciudate, o variabilă de text Python este de tip str, care înseamnă „șir” (”string”. Ai putea să te gândești la asta ca la o grămadă de litere „strânse” împreună ca un colier cu mărgele.
Important: atunci când specificați o valoare str, trebuie să utilizați ghilimele (simple sau duble). În primul rând, așa știe Python că intenționați să creați un str, spre deosebire de un alt tip. Exemple:
Observați, apropo, că un șir de cifre nu este același lucru cu un întreg. Pentru a înțelege:
schwarzenegger_weight = 249
action_movie = “300”
type(schwarzenegger_weight)
▌int
type(action_movie)
▌str
Vedeți? Ghilimelele fac toată diferența.
Lungimea unui șir
Probabil cel mai de bază este pur și simplu să întrebi despre lungimea unui șir sau despre numărul de caractere pe care le conține. Pentru a face acest lucru, includem numele variabilei între paranteze după cuvântul len:
len(slang)
▌3
len(donut_store)
▌13
După cum vom vedea, operația len() (și multe altele ca aceasta) este un exemplu de funcție în Python. În limbajul adecvat, atunci când scriem o linie de cod precum len (donut_store) spunem că „apelăm funcția”, ceea ce înseamnă pur și simplu să o invocăm sau să o declanșăm.
Mai mult lingo: din motive obscure, valoarea din interiorul parantezelor (aici, donut_store) este numită un argument pentru funcție. Și spunem că „trecem” unul sau mai multe argumente unei funcții atunci când o apelăm.
Toți acești termeni pot părea pedanți, dar sunt exacți și folosiți universal, așa că asigurați-vă că îi învățați. Linia de cod precedentă poate fi complet rezumată spunând:
„Apelăm la funcțialen() și îi trecemvariabiladonut_store ca argument.”
Rețineți, apropo, că funcția len() așteaptă un argument str. Nu puteți apela len() cu o variabilă int sau float ca argument:
schwarzenegger_weight = 249
len(schwarzenegger_weight)
▌TypeError: object of type ‘int’ has no len()
(Ați putea crede că „lungimea” unui int ar fi numărul său de cifre, dar nu e așa.)
Un lucru pe care elevii îl confundă adesea este diferența dintre o variabilă de șir numită și cea a unei valori de șir (nenumită). Luați în considerare diferența în rezultatele următoarelor:
slang = ‘lit’
len(slang)
▌3
len(‘slang’ )
▌5
În primul exemplu, am întrebat „cât de lungă este valoarea în variabila slang?” Răspunsul a fost 3, deoarece „lit” are trei caractere. În al doilea exemplu, am întrebat „cât de lung este cuvântul „slang”?” iar răspunsul este 5. Nu uitați: numele variabilelor nu se pun niciodată între ghilimele. Dacă ceva este între ghilimele, este luat literal.
Combinarea și tipărirea variabilelor
Puteți face o mulțime de lucruri cu alte variabile decât să le creați. Un lucru pe care doriți să-l faceți frecvent este să imprimați o variabilă, ceea ce înseamnă să puneți valoarea acesteia pe pagină, astfel încât să o puteți vedea. Acest lucru se face cu ușurință apelând funcția print():
Din nou, nu ratați diferența crucială dintre tipărirea lui „slang” și tipărirea lui slang. Primul este literal și cel de-al doilea nu. În prima dintre acestea, trecem cuvântul „slang” ca argument, nu variabila slang.
Deseori vom dori să combinăm biți de informații într-o singură instrucțiune de tipărire. De obicei, una dintre variabile este un șir care conține mesajul general. Există mai multe modalități de a realiza acest lucru, dar cea mai flexibilă se va dovedi a fi metoda.format().
O metodă este foarte asemănătoare cu o funcție, dar nu exact. Diferența constă în sintaxa utilizată pentru a o numi. Când apelați o funcție (cum ar fi type() sau len()), pur și simplu introduceți numele acesteia, urmată de o pereche de paranteze în interiorul cărora puneți argumentele (separate prin virgule, dacă există mai multe). Dar când „apelați o metodă”, puneți o variabilă înainte de un punct („.”) și numele metodei, apoi parantezele. Aceasta este denumită „apelarea metodei pe variabilă”.
Sună mai confuz decât este. Iată un exemplu de .format() în acțiune:
Rețineți cum scriem „message.format” în loc de „format”. Acest lucru se datorează faptului că .format() este o metodă, nu o funcție. Spunem că apelăm .format() „pe” message și trecem price_of_ Christian_Louboutin_shoes ca argument. (7) De asemenea, asigurați-vă că observați parantezele duble „))” la sfârșitul ultimei linii. Avem nevoie de amândouă, deoarece în programare, fiecare paranteză stângă trebuie să se potrivească cu o paranteză dreaptă corespunzătoare. Întrucât apelăm două funcții / metode pe o singură linie (print() și .format()), aveam două paranteze din stânga pe acea linie. Fiecare are nevoie de un partener.
În ceea ce privește specificul modului în care funcționează .format(), veți vedea că variabila de șir pe care o apelați poate include perechi de curlie (acolade). Acestea sunt substituenți pentru locul în care trebuie să lipiți valorile altor variabile în ieșire. Aceste variabile sunt apoi incluse ca argumente pentru metoda .format(). Codul de mai sus produce această ieșire:
▌Honey, I spent $895.95 today!
Adesea, în loc să creăm un nou nume de variabilă pentru a menține șirul preformatat, doar vom folosi print() literalmente, astfel:
print(“Honey, I spent ${} today!”.format(
price_of_Christian_Louboutin_shoes))
Încă apelăm de fapt .format() la o variabilă aici, doar că nu ne-am deranjat să numim variabila. De asemenea, observați că codul nostru era prea lung pentru a se potrivi frumos pe o singură linie, așa că l-am rupt în două și am indentat a doua linie pentru a clarifica faptul că „price_of_…” nu își începea propria linie nouă. În mod crucial, toate parantezele sunt încă împerecheate, două câte două, chiar dacă parantezele din stânga sunt pe o linie diferită de parantezele din dreapta corespunzătoare.
În cele din urmă, iată un exemplu mai lung cu mai multe variabile:
▌Customer Pedro Pascal bought 3 items worth $91.73.
Puteți vedea cum putem trece mai mult de un argument unei funcții / metode pur și simplu separându-le cu virgule în interiorul parantezelor.
Note
(1) Această utilizare a termenului „mediu” este diferită de termenul „mediu de programare”.
(2) Strict vorbind, deși în limbaje precum Java variabilele au într-adevăr tipuri, în Python valorile au tipuri, nu variabilele. Această distincție nu este însă importantă pentru noi.
(3) Apropo, cuvântul cod este gramatical un substantiv de masă, nu un substantiv de numărare. Prin urmare, este potrivit să spunem „Am scris un cod aseară”, nu „Am scris câteva coduri aseară”. Dacă folosiți greșit acest lucru, veți fi marcat imediat ca începător.
(4) Oh, și o altă regulă: un nume variabil nu poate începe cu o cifră. Deci, r2d2 este un nume de variabilă legală, dar nu și 007bond.
(5) Și consider în totalitate faptul că variabila revolution nu este numită foarte bine. Am ales-o doar pentru a evidenția rapid o diferență.
(6) Dacă sunteți curios, acest lucru se datorează faptului că în limbajul de programare al computerului un „număr cu virgulă mobilă” înseamnă un număr în care punctul zecimal ar putea fi oriunde. Cu un număr întreg ca -52, punctul zecimal este implicit în partea dreaptă a secvenței de cifre. Dar cu numere precum -5,2 sau -,52 sau -000052 sau chiar 520000, punctul zecimal a „plutit” departe de această poziție fixă.
(7) Ori de câte ori mă refer la o metodă aici, voi pune un punct înaintea numelui său. De exemplu, nu este metoda „format()”, ci metoda „.format()”.


 Sfetcu, Nicolae (2022), Tehnologia blockchain, IT & C, 1:1, 11-15, DOI: 10.58679/IT57155, https://www.internetmobile.ro/tehnologia-blockchain/
 (Formarea canalului de blocuri sub forma arborelui Merkle. Lanțul principal (B0…B8) constă din cea mai lungă serie de blocuri pornind de la blocul inițial (B0) până la blocul curent (B8). Toate celelalte blocuri sunt blocuri orfane care se găsesc în afara lanțului principal.)
 (Taxonomie de amenințare aplicabilă activelor Big Data)
